標準誤差とは?標準偏差との違いから計算式・信頼区間まで徹底解説
📌 【この記事の重要ポイントまとめ】
- 要点1:標準偏差(SD)は「集めたデータそのものの散らばり」を示すのに対し、標準誤差(SE)は「推定した標本平均のブレ幅(推定の不確かさ)」を表す全く異なる尺度である。
- 要点2:計算式で「√n」で割る背景には中心極限定理が存在し、誤差の幅を半分に抑え込むにはサンプルサイズを4倍に増やさなければならないという数学的制約を持つ。
- 要点3:学術論文のエラーバー表記や95%信頼区間の設計において、SDとSEの意図的なすり替えは「データの見栄え偽装」とみなされるリスクがあり、文脈に応じた厳格な使い分けが不可欠である。
【混同の元凶を解剖】標準誤差とは何か?標準偏差との決定的な違い
標準誤差(Standard Error: SE)を一言で定義するなら、「標本平均という推定値が持つばらつきの大きさ」です。これに対して標準偏差(Standard Deviation: SD)は、「手元にある個々のデータが平均値からどれくらい散らばっているか」を示します。言葉の響きは似通っていますが、見ている対象の次元が全く異なります。 この違いを理解する鍵は、推測統計学の基本概念である「母集団」と「標本(サンプル)」の関係性にあります。たとえば日本国内で働く全ビジネスパーソンの平均年収を知りたいとしましょう。数千万人におよぶ母集団全員を調査することは現実的ではないため、無作為に1,000人を抽出して「標本平均」を計算します。 ここで重要な問いが生じます。「今回抽出した1,000人の平均年収は、真の母平均と完全に一致しているだろうか」という疑問です。別の1,000人を抽出すれば標本平均は別の数値になり、さらに別の1,000人を抽出すればまた異なる数値になります。このように、標本抽出を何度も繰り返したときに「得られる標本平均たちが示すばらつき」を理論的に導き出した値こそが標準誤差です。 実務現場で混同が起きる背景には、「どちらもデータの散らばりを表している」という安易な思い込みがあります。標準偏差は「被験者ごとの身長の個人差」のような現実の散らばりであるのに対し、標準誤差は「何度も測定をやり直したときに、推定結果がどれくらい揺らぐか」という思考実験上の不確かさを数値化したものです。この決定的な境界線を曖昧にしたまま分析を進めることが、あらゆる誤認の引き金となっています。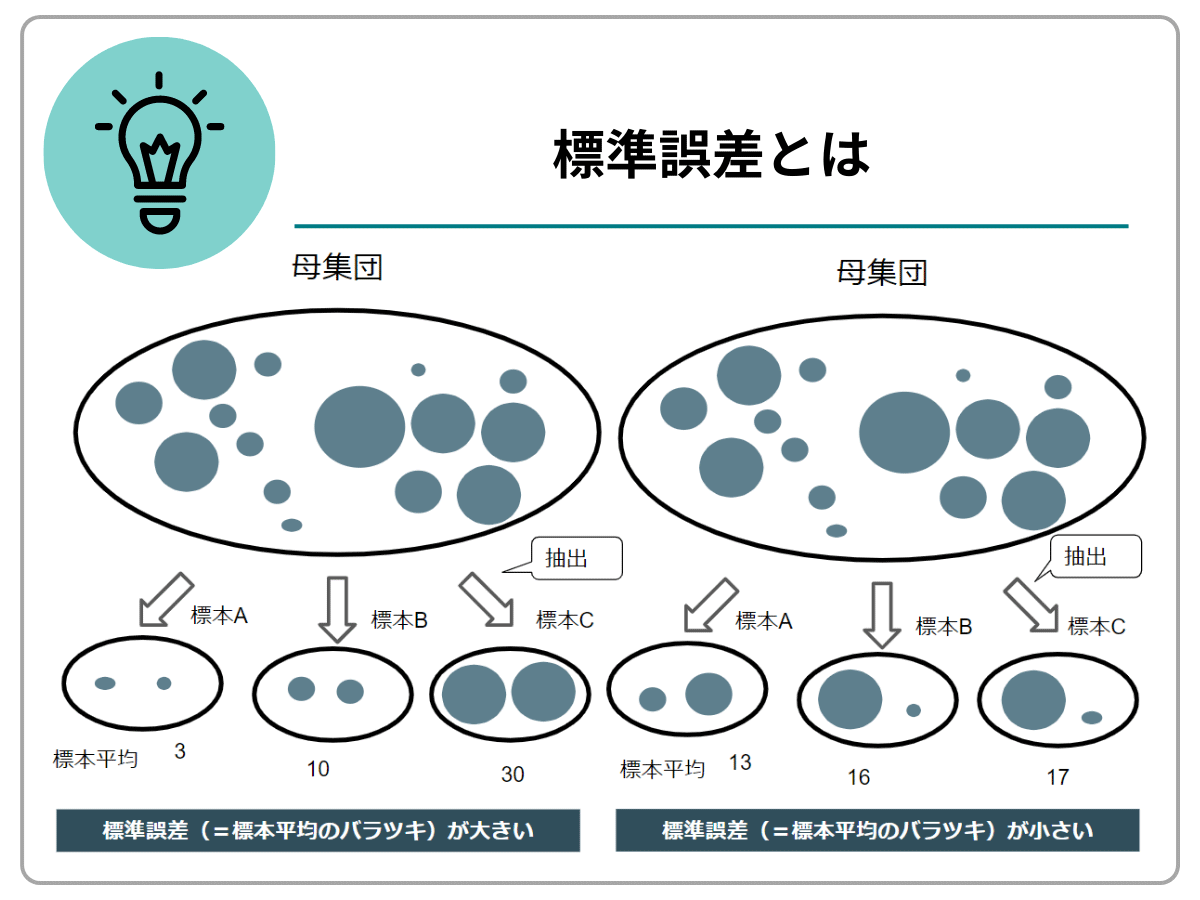
なぜ「√n」で割るのか?標準誤差の計算式と中心極限定理の本質
標準誤差の求め方は極めてシンプルであり、以下の計算式によって算出されます。 標準誤差(SE)= 標準偏差(s)÷ √n (サンプルサイズ) 数式そのものは単純ですが、多くの学習者がつまずくのが「なぜサンプルサイズ(n)そのものではなく、その平方根(√n)で割るのか」という疑問です。ここには、確率統計学の金字塔である中心極限定理(Central Limit Theorem)の美しいロジックが組み込まれています。 直感的な例として、サイコロを投げる実験を考えてみましょう。サイコロ1個を振ったときの出目の分散は一定ですが、100個同時に振ってその平均値を計算すると、出目の平均は極めて高い確率で理論値である「3.5」の周辺に集中します。極端な外れ値同士がお互いに打ち消し合うためです。 独立した複数の確率変数を足し合わせた場合、分散には「足し算ができる(加法性)」という性質があります。1個のデータの分散が $s^2$ であるとき、$n$ 個のデータを合計した値の分散は $n \times s^2$ となります。しかし、私たちが求めているのは合計ではなく「平均」です。平均を出すためには全体を $n$ で割る必要がありますが、分散の計算規則では、変数を $1/n$ 倍すると分散は $(1/n)^2$ 倍、すなわち $1/n^2$ 倍になります。 したがって、標本平均の分散は以下のように導かれます。 標本平均の分散 = (n × s²) ÷ n² = s² ÷ n 標準誤差は「標本平均の標準偏差」であるため、上記の分散に平方根をかけます。その結果、分子の $s^2$ は $s$(標準偏差)になり、分母の $n$ は $\sqrt{n}$(ルートn)になります。これが、分母が $\sqrt{n}$ になる数学的証明です。 この平方根の性質は、実務上極めて厳しい現実を突きつけます。「推定の精度を2倍にする(標準誤差を2分の1にする)ためには、サンプルサイズを4倍に増やさなければならない」という点です。サンプルを100件から200件に倍増させても、誤差は $\sqrt{2} \approx 1.414$ で割られるため、約29%しか減少しません。調査コストと精度のトレードオフを計算する上で、この「平方根の制約」を認識しておくことは実務者の必須リテラシーといえます。【データ徹底比較】標準偏差(SD)と標準誤差(SE)の役割と相違点
データ分析の実務において、標準偏差(SD)と標準誤差(SE)のどちらを採用すべきかは、分析の目的によって明確に分かれます。両者の違いを以下の比較表に整理しました。| 項目 | 詳細・数値データ | 一般的な基準・相場 | 編集部の見解・評価 |
|---|---|---|---|
| 表す対象 | SD:個々の測定値のばらつき SE:推定した標本平均のばらつき | 母集団記述 vs 母数推定 | 目的が「現状把握」ならSD、「仮説検証・真の値の推定」ならSEを選択すべき。 |
| サンプル数(n)増加時の挙動 | SD:一定値(母標準偏差σ)に収束 SE:限りなくゼロに近づく | n=100からn=10,000でSEは10分の1に縮小 | nを増やせばSEは必ず小さくなるため、SEの小ささだけを誇るのは統計的に無意味。 |
| 計算式 | SD:s = √[Σ(x - x̄)² / (n - 1)] SE:SE = s / √n | 不偏分散の平方根を√nで除算 | 分母の平方根(√n)が推定のブレを急激に抑制する数学的フィルターとして機能。 |
| エラーバー(グラフ)の用途 | SD:データの個体差の幅を示す SE:平均値の推定精度の幅を示す | 学術誌・業界規定により明記義務あり | SEによるエラーバーは見た目が狭くなるため、「ばらつきが小さい」と誤認させやすい罠がある。 |
【実態検証】論文やプレゼン資料の「エラーバー」で現場が炎上する理由
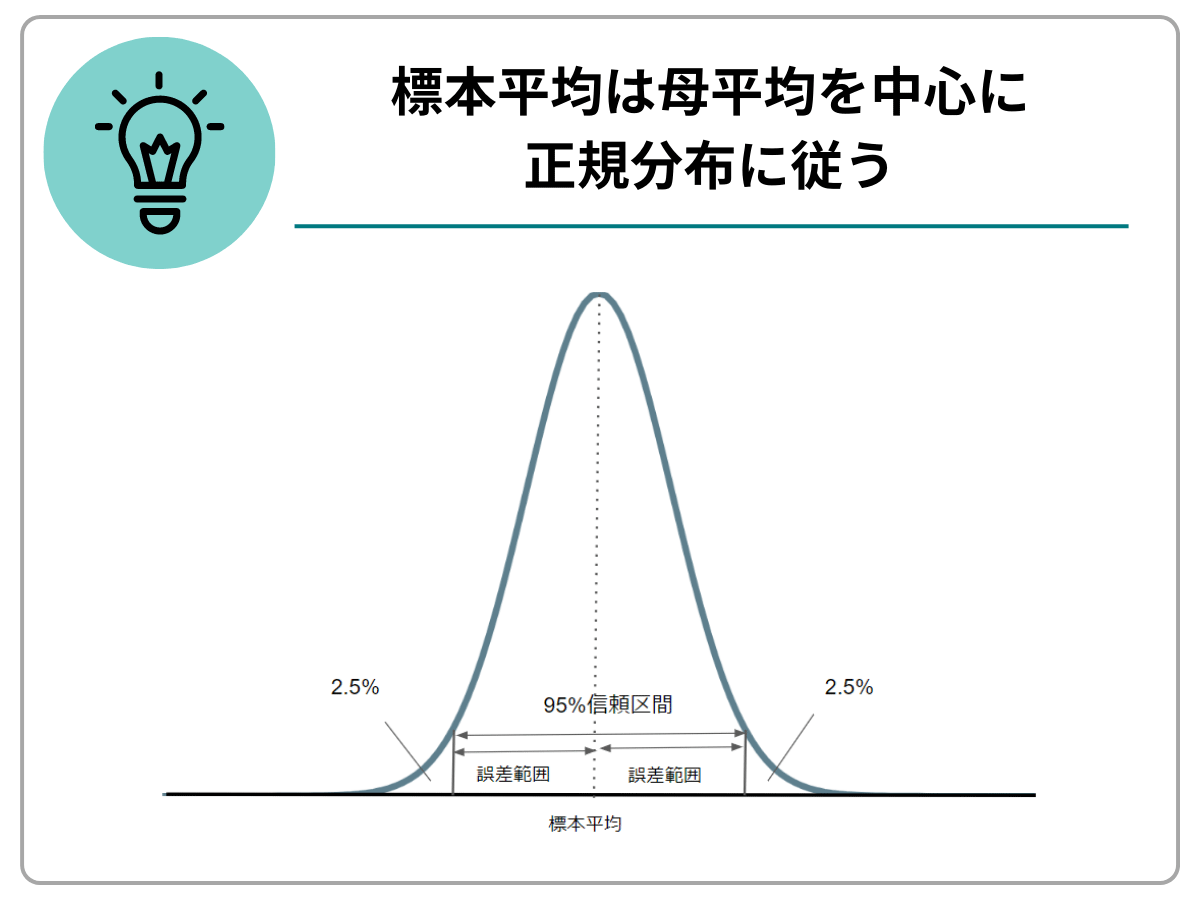
学術界や企業の企画開発部において、頻繁に議論が紛糾するのが「グラフのエラーバー(誤差範囲のヒゲ)」にSDとSEのどちらをプロットしているかという問題です。 論文執筆に携わる大学院生の手記や、製薬・バイオ系の研究開発現場への聞き取り調査では、次のような赤裸々な証言が数多く寄せられています。 「自社製品と競合製品の性能比較グラフを作った際、見栄えを良くするために棒グラフのエラーバーを勝手に標準誤差(SE)にして提出したところ、技術顧問から『データのばらつきを意図的に隠蔽して製品の均一性を過大アピールしている』と激怒された」(化学メーカー開発担当者) 「査読者から『キャプションに明記されていないこのエラーバーはSDなのかSEなのか、あるいは95%信頼区間なのか』という指摘を受け、再実験と全グラフの修正を命じられた」(生体工学分野の研究者) こうした現場の混乱が起きる最大の原因は、「標準誤差を用いると、グラフのヒゲが極端に短くなり、データが綺麗に揃っているように見えてしまう」点にあります。サンプルサイズが $n = 100$ であれば、標準誤差は標準偏差の10分の1の長さしかありません。個々のデータが大きくばらついているにもかかわらず、SEでエラーバーを描くと、あたかも製品や実験結果のブレが極小であるかのような錯覚を与えてしまいます。 国際的な主要学術誌(Nature系や医学系トップジャーナルなど)の投稿規定では、エラーバーがSDなのかSEなのか、あるいは信頼区間なのかをキャプション内に明記することが義務付けられています。さらに現在では、「標本の散らばりを見せたいなら個々のプロット点(ドット)や箱ひげ図を載せ、母平均の推定精度を論じたいなら信頼区間95パーセント(95% CI)を明記せよ」という指針が世界的なスタンダードとなりつつあります。 なお、正規分布を仮定した場合、95%信頼区間は以下の式で求められます。 95%信頼区間 = 標本平均 ± 1.96 × SE 標準誤差に約2(正確には1.96)を掛けたものが95%信頼区間の幅となります。「真の母平均が95%の確率で収まる範囲」を提示したいのであれば、SE単体をエラーバーにするのではなく、信頼区間として明示するアプローチが最も誤解を招きません。一般に知られていない盲点と標準誤差の目安・解釈の罠
「標準誤差の目安はいくつくらいが適正ですか?」という質問が、知恵袋や統計コミュニティで頻繁に見受けられます。しかし、統計学的に見て「標準誤差に共通の数値目安(絶対基準)は存在しない」というのが揺るぎない結論です。 標準誤差は元の測定データの単位(円、kg、秒、%など)をそのまま引き継ぎます。年収データの標準誤差が「50,000円」であれば非常に高精度な推定といえますが、体重測定の標準誤差が「50,000g(50kg)」であれば推定として使い物になりません。推定の精度を相対的に測りたい場合は、標準誤差を標本平均で割った「相対標準誤差(RSE: Relative Standard Error)」を算出します。国の基幹統計や社会調査では、RSEが5%以下、あるいは10%以下であることをひとつの信頼性基準とする運用が一般的です。 さらに、人間の心理には「代表性ヒューリスティクス」や「少数の法則」と呼ばれる認知バイアスが存在します。心理学者ダニエル・カーネマンらが警鐘を鳴らしたように、人間は「わずか数十件のサンプルから得られた標本平均」であっても、それが母集団全体を正しく代表していると思い込みがちです。 サンプルサイズが小さすぎる場合、標準誤差の計算に用いる標本標準偏差 $s$ 自体が不安定になり、算出されたSEそのものが大きな誤差を含んでしまいます。推測統計学の基本は、サンプルの背後にある不確実性を常に疑う姿勢にあります。手元のSEの数値がどれほど小さく見えても、それが「十分なサンプルサイズに基づいているか」「母集団からの無作為抽出が担保されているか」を厳格に吟味しなければ、重大な意思決定ミスを犯すことになります。【プロの結論】標準誤差を正しく使いこなすための判断基準
データを取り扱うプロフェッショナルとして、SDとSEをどう選び分けるべきか。以下の明確な判断基準を日常の業務フローに組み込むことを推奨します。 【標準偏差(SD)を使うべき場面】:データのばらつきそのものが主題であるとき - 顧客層の年齢分布や購買金額の個人差を把握したい場合 - 製造ラインにおける製品精度のばらつき(公差・品質管理)を報告する場合 - 読者や意思決定者に「個々のユーザーがどれくらい散らばっているか」という現実のリアルを伝えたい場合 【標準誤差(SE)または信頼区間を使うべき場面】:母集団の真の値を推測したいとき - A/BテストのCVR(コンバージョン率)に統計的に意味のある差があるか検証する場合 - アンケート調査の標本平均から、全顧客の平均満足度を推定する場合 - 学術論文で「今回得られた実験結果(平均値)の不確かさ・推定精度」を明示する場合 【絶対に避けるべきNGパターン】: - 個体差が激しいデータであるにもかかわらず、グラフの見た目を良く見せるためだけにSEを選択すること - エラーバーを描きながら、それがSDなのかSEなのか注記を怠ること - nが数件程度の極小サンプルで求めたSEを根拠に、断定的な結論を下すこと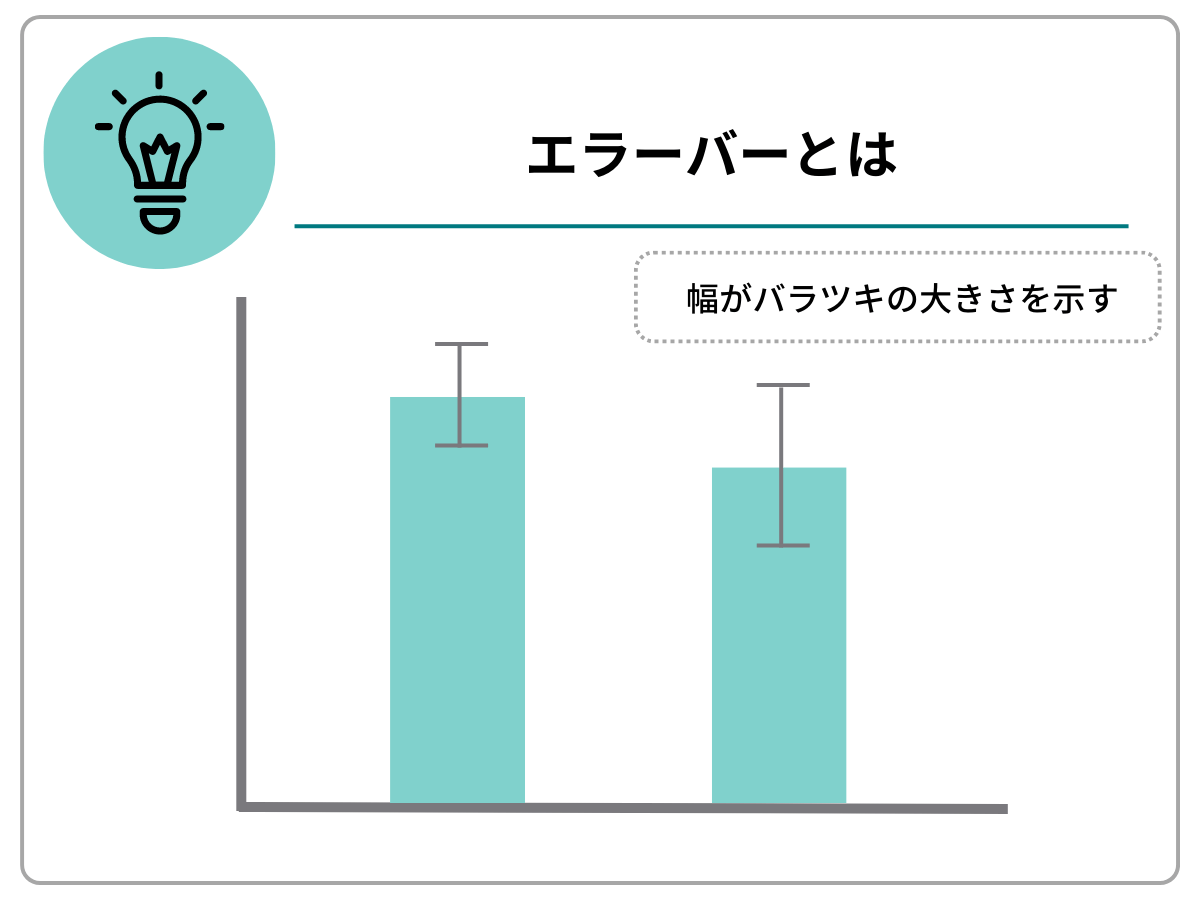
【標準誤差とは】に関するよくある質問(FAQ)
Q1:標準誤差が「0」になることは理論上あり得ますか?
A1:標本調査である限り、標準誤差が完全に0になることはありません。ただし、サンプルサイズ(n)を無限大に近づけるか、あるいは母集団の構成員全員を漏れなく調査する「全数調査(国勢調査など)」を実施した場合、サンプリングに伴うブレが存在しなくなるため、標準誤差の概念そのものが不要(実質的にゼロ)になります。
Q2:サンプルサイズを2倍に増やせば、標準誤差は半分になりますか?
A2:半分にはなりません。標準誤差の計算式では分母が「√n」となっているため、サンプルサイズを2倍にしても誤差は「1÷√2(約0.71倍)」となり、約29%しか減少しません。標準誤差を現在の2分の1に半減させたいのであれば、サンプルサイズを元の「4倍」に増やす必要があります。
Q3:Excelで標準誤差を求める際、STDEV.Pを使ってはいけませんか?
A3:原則として使ってはいけません。STDEV.Pは母集団全体の全数データが手元にある場合に使用する関数です。標本データから母平均を推測する標準誤差の計算では、不偏分散に基づく「STDEV.S」を使用しなければ、ばらつきを過小評価してしまい、推定精度を誤認する原因となります。
Q4:学会発表のポスターでエラーバーを引く際、SDとSEのどちらが無難ですか?
A4:分野によって慣習が分かれますが、最も安全なのは「どちらを採用したかをキャプションに太字で明記する」ことです。医学・生物学系ではSEや95%信頼区間が好まれる傾向があり、心理学や工学系では個体差を示すSDが重視される傾向があります。迷った場合は、平均値の点推定だけでなく、データの全体像がわかるドットプロットやバイオリンプロットを併記するのが2026年現在の国際標準です。 (出典: 標準 誤差 と は(Yahoo!ニュース))
まとめ:データの背後にある「不確実性」を正しく見極めるために
標準誤差(SE)は、私たちが限られた標本データから広大な母集団の真理を見通そうとする際に、その推測にどれほどの「不確かさ」が伴っているかを教えてくれる羅針盤です。手元にあるデータの散らばりを示す標準偏差(SD)と混同することなく、両者の役割を正しく切り分けることが、データリテラシーの第一歩となります。 計算式で $\sqrt{n}$ で割る理由を理解していれば、精度の向上にはサンプルの劇的な追加が必要であるというコスト感覚が身につきます。また、エラーバーの表記ルールを遵守していれば、見栄えの良さに惑わされることなく、真に誠実なデータコミュニケーションが可能になります。 単にツールが出力した数値を眺めるのではなく、「この数値は何のばらつきを証明しているのか」を常に自問自答すること。その批判的思考こそが、溢れるデータ社会において誤った意思決定から身を守る最大の防壁となるはずです。
情報を整理して届けることが得意なWebディレクター。ユーザー視点に立った記事作成を目指しています。