記述統計とは?推測統計との違いや代表値の罠を暴くデータ分析超入門
目次
📌 【この記事の重要ポイントまとめ】
- 要点1:記述統計の本質は「手元にある観測データの全体像を正しく要約・記述すること」であり、一部から全体を推し量る「推測統計」とは目的もアプローチも根本から異なる。
- 要点2:平均値だけに頼る分析は極めて危険であり、中央値・最頻値の併用や、分散・標準偏差・箱ひげ図を用いた「データの散らばり」の可視化が不可欠である。
- 要点3:Excelの「データ分析」ツールを使えば初心者でも数秒で要約統計量を算出できるが、数値を正しく解釈するリテラシーがなければ致命的な経営判断ミスを招く。
【基礎からわかる】記述統計とは?推測統計との決定的な違いとデータ要約の本質
データ分析の世界に足を踏み入れた初心者が最初に直面する壁が、統計学の二大体系である「記述統計」と「推測統計」の区別です。心理学事典や統計学会の公式資料でも明確に定義されている通り、統計学の目的は「取得したデータそのものの特徴を表現すること」と「そのデータから母集団の性質を推論すること」の2つに大別されます。 前者を担うのが記述統計(Descriptive Statistics)です。記述統計の主たる役割は、手元に集まった膨大な数値の山を、人間が直感的に理解できる形に「要約」することにあります。例えば、全社員1,000人の健康診断結果や、Webサイトを訪れた5万人分のアクセスログをそのまま眺めても、人間は何も判断できません。そこで、平均身長を割り出したり、年齢層ごとの度数分布表を作ったり、散布図を描いて傾向を掴む行為そのものが記述統計のアプローチです。 歴史を紐解くと、この記述統計の基礎体系を確立したのはロンドン大学ユニバーシティ・カレッジ教授を務めたカール・ピアソン(1857–1936)でした。ピアソンは、データのばらつきを捉える「標準偏差」の概念を提唱し、ヒストグラムや相関係数の実用化に多大な貢献を果たしました。ピアソンの研究は、複雑な自然界や社会現象を客観的な指標で記述するためのものであり、現代のビジネスインテリジェンスの原型となっています。 一方、手元のサンプル(標本)から、背後にある巨大な集団(母集団)の性質を確率的に推し量るのが推測統計(Inferential Statistics)です。推測統計は、ロナルド・フィッシャー(1890–1962)らが整備した分散分析や仮説検定に代表されるように、「抽出した1,000人の世論調査から有権者1億人の支持率を推定する」「投薬実験の結果から薬の有効性を科学的に証明する」といった場面で用いられます。 手元にあるデータそのものを誠実に描き出すのが記述統計、手元にない全体像を確率論で探るのが推測統計。この2つは「車の両輪」であり、記述統計による地盤固めを怠ったまま推測統計を適用しても、無意味な仮説検定に終わるだけです。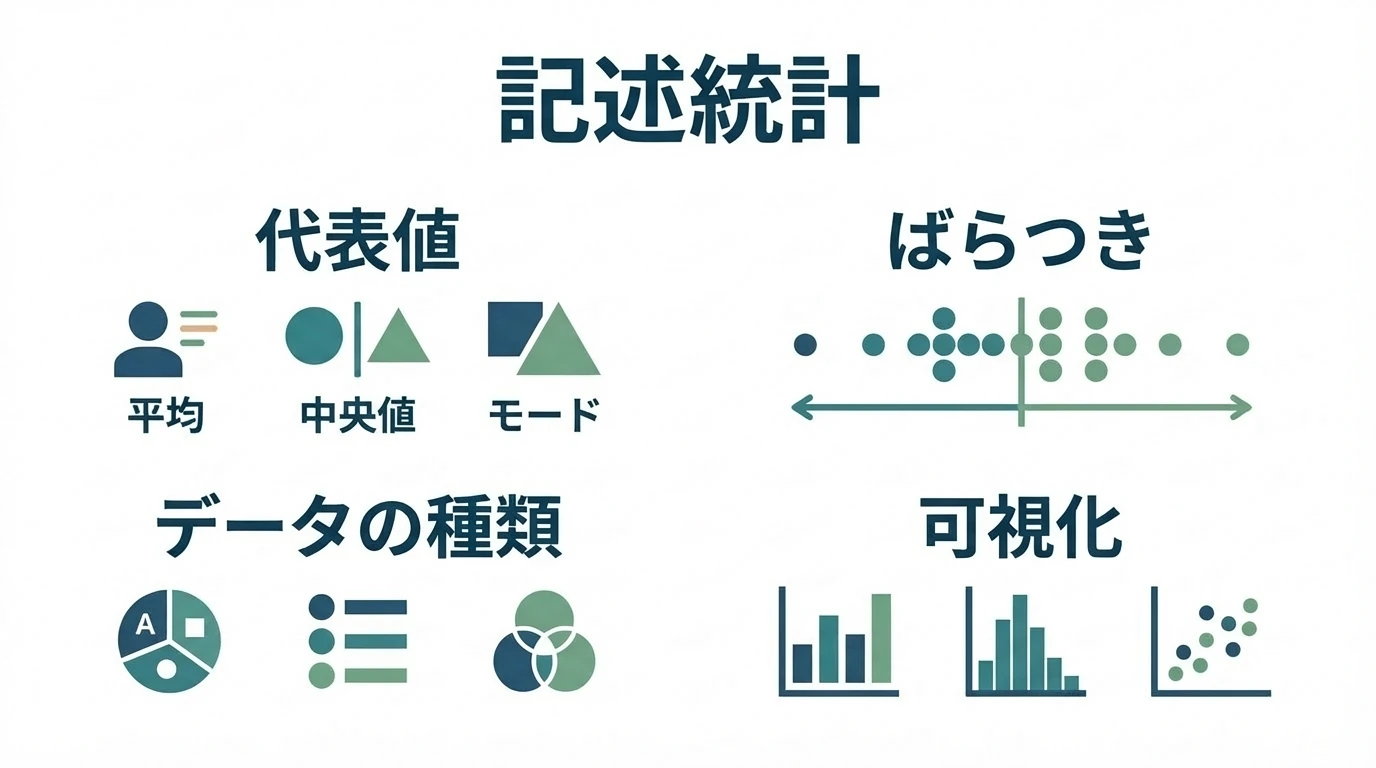
記述統計の目的とメリット|なぜビジネスの意思決定で真っ先に必要なのか
記述統計を学ぶ最大の目的は、混沌とした生データを「他者と共有可能で、意思決定に耐えうる客観情報」へと昇華させる点にあります。生のローデータ(未加工データ)のままでは意思決定者の認知リソースを浪費させるだけですが、適切に要約された指標は組織の共通言語となります。 具体例として、ある小売チェーンで新設された直営店舗の売上データを考えてみましょう。開店から100日間の日次売上データが手元にある場合、記述統計を活用することで次のメリットが得られます。 * 全体像の即時把握:1日あたりの平均売上高や、最も頻繁に発生した売上規模を把握できる。 * ばらつきの可視化:平日と休日の売上差、天候による売上の乱高下(散らばり具合)を標準偏差として数値化できる。 * 異常値の早期検知:オープン記念セールの特需や、台風による営業停止などの特異な日を「外れ値」として客観的に特定できる。 * 施策の効果検証の土台:キャンペーン実施前後のデータをそれぞれ記述・要約して比較することで、手応えを肌感覚ではなく数値で共有できる。 サイコロを10回振って出た目(例えば「3, 5, 2, 6, 1, 4, 3, 3, 2, 5」)を要約し、「平均は3.4、最も多く出た目は3」と表現するだけでも立派な記述統計です。ビジネスの現場では、このシンプルな作業を怠り、主観的な印象だけで「最近調子が良い」「客足が落ちている」と議論を進めてしまう組織が散見されます。主観を排除し、事実を白日の下に晒すことこそが記述統計の真の価値です。【徹底解剖】記述統計と推測統計の違いが一目でわかる比較データ
実務における適切な使い分けを理解するために、両者の機能と役割を構造的に整理しました。次の比較表は、データ分析プロジェクトを立ち上げる際の実務的基準となります。| 項目 | 記述統計(Descriptive) | 推測統計(Inferential) | 編集部の見解・実務上の注意点 |
|---|---|---|---|
| 主目的 | 手元にあるデータの特性を要約・視覚化する | 標本から未知の母集団全体を推測・検証する | 記述なくして推測なし。順序を取り違えると誤謬が生じる。 |
| 扱うデータの範囲 | 収集・観測されたデータそのもの(手元の100%) | 母集団からランダム抽出されたサンプルデータ | サンプリングに偏り(バイアス)があると推測統計は機能しない。 |
| 主な代表的手法・指標 | 平均値、中央値、分散、標準偏差、ヒストグラム、相関係数 | 区間推定、t検定、カイ二乗検定、分散分析(ANOVA)、回帰分析 | 記述統計の手法は推測統計の計算過程でも基礎パーツとして使われる。 |
| 代表的なビジネス活用例 | 当月の全店売上レポート、顧客満足度アンケートの分布確認 | 新機能のA/Bテスト有意差判定、テレビ視聴率の全体推定 | 現場報告では記述統計で十分なケースが約7割を占める。 |
| 結論の確実性 | 手元のデータに関しては100%確実(計算ミスを除く) | 常に一定の誤差や確率的リスク(有意水準5%など)を伴う | 経営陣への報告では「確実な事実」と「推測」の峻別が絶対条件。 |

データの散らばりを可視化する技術|分散・標準偏差の求め方から箱ひげ図まで
代表値が「データの中心がどこにあるか」を示すのに対し、実務においてそれ以上に死活問題となるのが「データが中心からどれくらい散らばっているか」です。この散らばり(散布度)を捉える指標がなければ、事業のリスク管理は成立しません。 例えば、平均日商がともに100万円の2つの店舗(A店・B店)があったとします。 A店は毎日95万〜105万円の間で極めて安定して推移しているのに対し、B店はある日は20万円、別の日には300万円と乱高下していたらどうでしょうか。代表値(平均値)は同じ100万円であっても、B店は仕入れ計画や人員配置の難易度が桁違いに高く、経営破綻のリスクを抱えています。この「散らばり」を定量化するのが、分散と標準偏差です。分散と標準偏差の求め方
散らばりを計算する際、各データが平均値からどれくらい離れているかを表す数値を「偏差(データ値 − 平均値)」と呼びます。しかし、偏差をそのまま足し合わせるとプラスとマイナスが相殺されて必ず合計がゼロになってしまいます。そこで、次の手順を踏みます。 1. 各データの偏差をそれぞれ2乗する(マイナスをプラスに変換)。 2. その2乗した値の合計を計算し、データの総数で割る。これが分散(Variance)である。 3. 2乗したことで単位が変わってしまっているため(例:円の2乗)、分散の平方根(ルート)を取る。これが標準偏差(Standard Deviation / SD)である。 標準偏差の最大のメリットは、元データと同じ単位(円、kg、点数など)でばらつきの幅を直感的に把握できる点です。正規分布に従うデータの場合、平均値から「±1標準偏差」の範囲に全体の約68.3%のデータが収まり、「±2標準偏差」の範囲には約95.4%のデータが収まるという明確な統計的性質が存在します。度数分布表・ヒストグラム・箱ひげ図による視覚化
数式だけでなく、視覚的にデータの分布構造を捉えるツールとして次の手法をマスターしておく必要があります。 * 度数分布表とヒストグラム:データを一定の区間(階級)に区切り、各区間に何個のデータが存在するかを数え上げたのが度数分布表です。それを柱状のグラフにしたものがヒストグラムであり、データの山が1つなのか2つあるのか、左右対称なのか歪んでいるのかが一目で判明します。 * 四分位範囲(IQR)と箱ひげ図:データを昇順に並べ、25%地点(第1四分位数)、50%地点(中央値)、75%地点(第3四分位数)を求め、中央の50%が含まれる幅を「四分位範囲」と呼びます。これを長方形の箱と上下のひげで表現したものが箱ひげ図です。外れ値が「点」として明確にプロットされるため、複数グループのデータ分布のばらつきを比較する際に威力を発揮します。 * 散布図と相関係数:2つの量的変数(例:気温とビールの売上)の関係性を探るには、縦軸と横軸にデータをプロットする散布図を用います。この直線的な関連性の強さを−1.0から+1.0の範囲で数値化したものが相関係数(ピアソンの積率相関係数)です。ただし、相関関係があるからといって因果関係があるとは限らない点には十分な警戒が必要です。【実態検証】エクセル分析ツール活用の現場リアルと「平均値の罠」の失敗談
2026年のビジネス現場において、複雑なプログラミング言語(PythonやR)を扱えなくても、Microsoft Excelの標準機能だけで高度な記述統計分析が完結します。特に必須となるのがExcelの「分析ツール」アドインです。 実務手順は極めてシンプルです。 「データ」タブ >「データ分析」>「基本統計量」を選択し、分析したいデータ範囲を指定。「統計情報」にチェックを入れて実行するだけで、平均、標準誤差、中央値、最頻値、標準偏差、分散、尖度、歪度、範囲、最小・最大値、合計、データの個数が瞬時に一覧出力されます。 しかし、ツールの操作が容易になったからこそ、解釈を誤る「ツールの奴隷」と化す現場担当者が急増しています。某大手ECモールに出店するアパレル企業のデータ分析担当者が、社内レビューで語ったリアルな手記には、次のような生々しい教訓が綴られていました。「当店の顧客1人あたり年間購入金額をExcelの基本統計量で算出したところ、平均値は約2万8000円でした。この数値を鵜呑みにした経営企画部は『客単価3万円を狙うプレミアム会員向け施策』に数千万円の予算を投じました。しかし、蓋を開けてみれば反応率は惨敗。改めて箱ひげ図とヒストグラムを描き直したところ、中央値はわずか6500円。年間数百万円を購入するごく一握りの転売事業者やヘビーユーザーが平均値を暴力的に押し上げていただけだったのです。平均値の罠に完全に踊らされていました」ネット上のQ&AサイトやSNSでも、「AIツールに『売上を要約して』とプロンプトを投げたら平均値しか返ってこず、そのまま役員会議に提出して厳しく詰められた」といった初学者の悲鳴が散見されます。アルゴリズムがどれほど進化しようとも、出力された要約統計量の背後にある「分布の形」を想像できなければ、データは武器ではなく凶器に変わります。

【プロの結論】データ分析で成功する人・大失敗する人の決定的な判断基準
記述統計を武器としてビジネス成果を出し続ける人と、数字に振り回されて現場を混乱させる人の境界線はどこにあるのでしょうか。メディア編集部および実務アナリストの知見から、明確な分水嶺となる判断基準を提示します。記述統計を正しく使いこなせる人の条件
* 「平均」を聞いた瞬間に「分散」や「中央値」を問い返せる人:単一の指標で現実を単純化せず、常に散らばりや分布の歪みを多面的に確認する姿勢が身についている。 * 数字を出す前にヒストグラムを描く人:計算式を実行する前に、必ず生データの分布形状を目視で確認し、外れ値の存在や二峰性(山が2つある状態)を直感的に把握できる。 * 記述統計と推測統計の境界線を弁えている人:「手元のアンケート結果がこうだった」という事実の記述と、「だから市場全体もこうであるはずだ」という推測を明確に区別してプレゼンテーションを構築できる。数字の罠にハマり大失敗する人の条件
* 外れ値を無批判に含めたまま計算を強行する人:入力ミスや特異なノイズデータをクレンジング(除外・補正)せず、機械的にエクセルのAVERAGE関数を適用してしまう。 * 相関関係を因果関係と盲信する人:散布図を描いて相関係数が高かったという記述的事実だけで、「A施策をやれば必ず売上Bが伸びる」と短絡的な経営判断を下す。 * 「AIが算出したから正しい」と盲従する人:生成AIやBIツールが出力した要約表の計算根拠や標本サイズ(n数)を一切検証せず、ブラックボックスのまま意思決定の根拠にする。 組織におけるデータ分析の失敗は、高等数学の知識不足ではなく、記述統計という「初歩のレンズ」の使い間違いから発生します。まずは手元のデータを徹底的に観察し、正しく記述し切ること。これがデータドリブン経営の絶対不可欠な第一歩です。【記述 統計 と は】に関するよくある質問(FAQ)
読者や初学者が実務で直面しやすい疑問について、一問一答形式で回答します。Q1:記述統計と推測統計のどちらから勉強を始めるべきですか?
A1:間違いなく「記述統計」から始めるべきです。推測統計で用いられる数式や確率モデル(正規分布、t分布など)は、記述統計で学ぶ平均・分散・標準偏差の概念が完全に理解できていることを前提として設計されています。基礎を飛ばして推測統計の検定手法だけを暗記しても、実務で適切な分析設計を行うことは不可能です。
Q2:エクセルで標準偏差を計算する際、STDEV.PとSTDEV.Sのどちらを使うべきですか?
A2:手元にあるデータが「対象全体のすべて(母集団)」である場合は「STDEV.P(Population)」を使用し、全体から抜き出した「一部のサンプル(標本)」から母集団を推測したい場合は「STDEV.S(Sample)」を使用します。全社員データの集計や当月の確定売上など、手元のデータそのものを記述・要約する目的ならSTDEV.Pが厳密な記述統計の定義に合致しています。
Q3:データの中に明らかな外れ値がある場合、どう処理するのが正解ですか?
A3:まずは入力ミスやシステムエラーなどの「異常値」でないかを確認し、ミスであれば修正または除外します。正当な測定値としての外れ値である場合は、安易に消去してはなりません。「外れ値を含めた全データの平均値・中央値」と「外れ値を除外した要約統計量」の両方を算出して並記し、なぜその外れ値が生じたのかという質的背景を注釈として添えるのがデータ分析者として最も誠実な報告手法です。 (出典: 記述 統計 と は(Yahoo!ニュース))
まとめ:手元のデータを疑い正しく要約することからすべてが始まる
データサイエンスの華々しい予測モデルや機械学習アルゴリズムに目を奪われがちな時代だからこそ、足元にある「記述統計」の重要性は一段と増しています。 記述統計の真髄は、手元の数字を単にまとめることではありません。平均値の背後に隠れた中央値に目を凝らし、標準偏差によって見えないリスクの振れ幅を捉え、ヒストグラムを通じてデータの歪みを浮き彫りにする――すなわち、「数字の向こうにある現場の真実」を歪みなく描き出す技術に他なりません。 自社の売上を見る際も、アンケートを読み解く際も、まずは条件反射的な平均値信仰を捨ててください。手元のデータを徹底的に記述し、その散らばりに向き合う誠実な姿勢こそが、不確実なビジネス環境において組織を致命的な判断ミスから救う最強の防壁となります。
Webライター
松本 陽菜 (Hina Matsumoto)
プロフィールを見る →
最新のトレンドや話題のニュースをわかりやすく解説するWebライターです。読者の皆様に役立つ情報を日々お届けしています。